Mesures de position et fréquences
Moyenne, médiane, quantiles et mode
Exercices corrigés

En statistique descriptive, l’analyse d’une série de données repose à la fois sur l’étude de sa distribution, à travers les fréquences (absolues et relatives), et sur la détermination de mesures de position telles que la moyenne, la médiane et le mode.

Il est fortement recommandé de ne pas consulter la solution avant d’avoir tenté sérieusement de résoudre les exercices par vous-même. Cet effort personnel est essentiel pour consolider votre compréhension.

Tous les calculs sont réalisés à l’aide du logiciel R, mais vous pouvez bien entendu utiliser Excel si vous le préférez.

J’encourage vivement l’utilisation de Rcmdr, particulièrement pour les jeux de données de taille modeste, car il permet d’effectuer les analyses sans avoir à coder.

Les scripts R sont également disponibles au format .txt : vous pouvez les télécharger ICI, les ouvrir avec RStudio, puis exécuter les lignes de code correspondant à chaque exercice pour vérifier vos résultats ou vous appuyer sur une démarche méthodologique.

Solution avec Rcmdr 

library(Rcmdr)

Charger votre jeu de données

Obtenir les statistiques descriptives:

  • Menu : Statistiques > Résumés > statistiques descriptives

  • Sélectionnez la ou les variables à résumer

  • Choisissez si vous voulez les statistiques :

    • Globalement, ou

    • Par groupe (ex : par sexe ou classe)

  • Clique sur OK

Exercice 1

Une entreprise analyse la satisfaction des clients selon leur type

Type de clientParticulierPMEGrande entreprise
Effectif503020
  1. Calculer les fréquences relatives
  2. Représenter la distribution en pourcentage
  3. Peut-on calculer la moyenne ? Argumentez
  4. Interpréter : quel segment est dominant ?
Réponse 1

1) On dispose des effectifs  de chaque catégorie de clients :

La fréquence relative d’une catégorie se calcule par :

\[
f_i = \frac{n_i}{N}
\]

\[
\text{avec :} \quad
\begin{cases}
n_i : \text{effectif de la catégorie} \\
N : \text{effectif total}
\end{cases}
\]

2)Le pourcentage se calcule par :

\[p_i = f_i \times 100\]

Le tableau résume le calcul :

Type_client

Effectif

Frequence_relative

Pourcentage

Particulier

50

0.5

50

PME

30

0.3

30

Grande entreprise

20

0.2

20

La distribution en pourcentage peut être représentée par un diagramme circulaire (camembert), particulièrement adapté à la visualisation des parts.
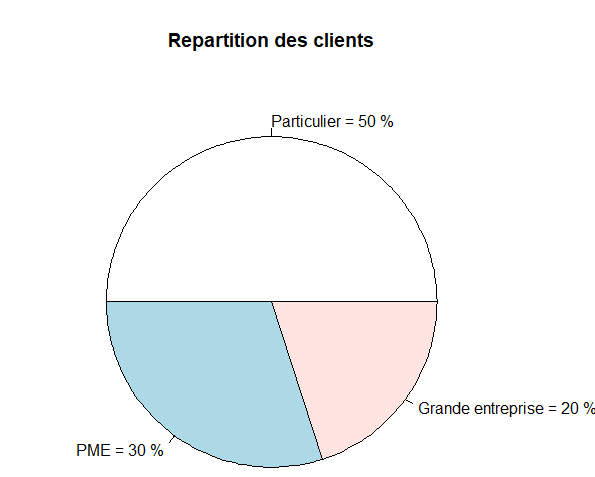
Diagramme circulaire représentant la répartition des clients en pourcentage (fréquence relative)

Un diagramme en barres peut également être utilisé en particulier s’il y a plusieurs catégories, car il facilite la comparaison entre les différents types de clients.
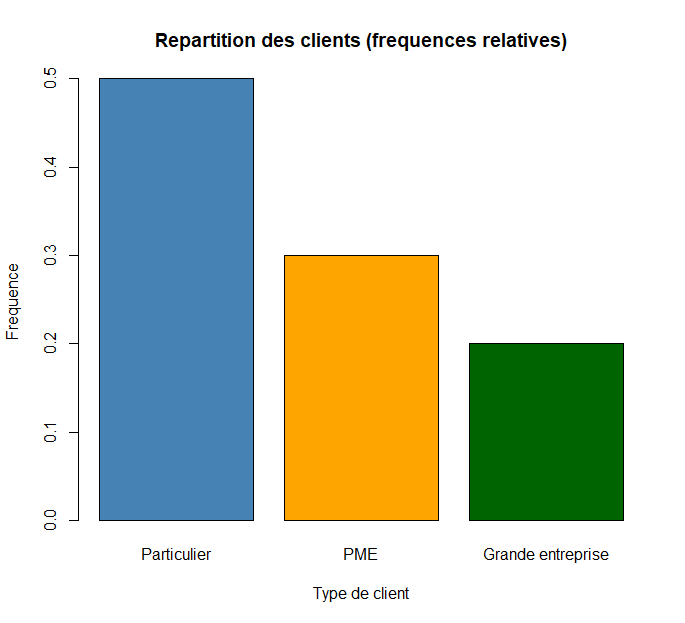
Diagramme en barres montrant la répartition des clients en fréquences relatives : 0,5 particuliers, 0,3 PME et 0,2 grandes entreprises

3)La moyenne ne peut pas être calculée dans ce cas, car la variable étudiée est qualitative (type de client). En effet, les modalités ne sont pas numériques et ne peuvent pas être additionnées ou moyennées. Seules des mesures comme les fréquences ou le mode sont pertinentes pour analyser ce type de données.

4) Le segment dominant est celui qui possède l’effectif ou la fréquence la plus élevée.

Ici :

  • Particulier : 50 %
  • PME : 30 %
  • Grande entreprise : 20 %

Donc, le segment dominant est celui des particuliers, puisqu’il représente 50 % de la clientèle totale.

Interprétation dans un contexte business

Cela signifie que l’entreprise dépend principalement du marché des particuliers.
D’un point de vue managérial, cela peut suggérer :

  • de renforcer les actions marketing destinées aux particuliers
  • de développer davantage l’offre pour les PME et les grandes entreprises si l’entreprise souhaite diversifier sa clientèle
  • d’adapter la stratégie commerciale au segment majoritaire.

Exercice 2

Une entreprise analyse les dépenses mensuelles (en €) de ses clients, regroupées dans le tableau suivant :

Dépenses (€)[0–100[[100–200[[200–300[[300–400[[400–500[
Effectif1025401510
  1. Calculez les fréquences cumulées et représenter les avec un graphique
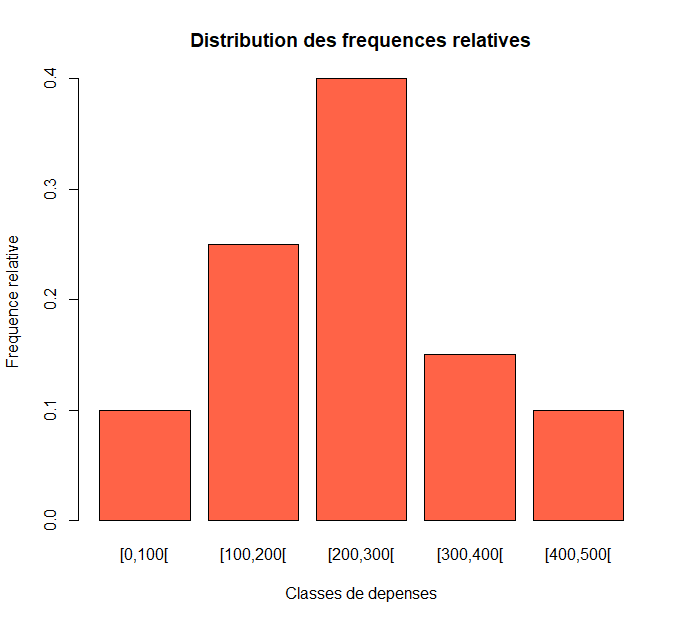
  2. Calculez les fréquences relatives et représenter les avec un graphique
  3. Quelle est la moyenne des dépenses mensuelles ?
  4. Identifiez la classe modale
  5. Comment se répartissent les dépenses des clients ?
  6. L’entreprise cible-t-elle plutôt des petits ou gros consommateurs ?
  7. Quelle stratégie marketing pourrait être envisagée ?
  8. Si l’entreprise souhaite cibler les 25 % de clients les plus dépensiers, à partir de quel niveau de dépense doit-elle concentrer ses efforts ?
Réponse 1

1)Fréquences cumulées :
Les fréquences cumulées sont obtenues en additionnant progressivement les fréquences absolues.

Classe           Effectif            Frequence_cumulee

1   [0,100[       10                   10

2 [100,200[       25                35

3 [200,300[       40                75

4 [300,400[       15                90

5 [400,500[       10               100

Graphique montrant l’accumulation des fréquences:La courbe ogive est le standard pour visualiser les fréquences cumulées car elle montre clairement la progression et permet de lire des seuils directement sur le graphique.
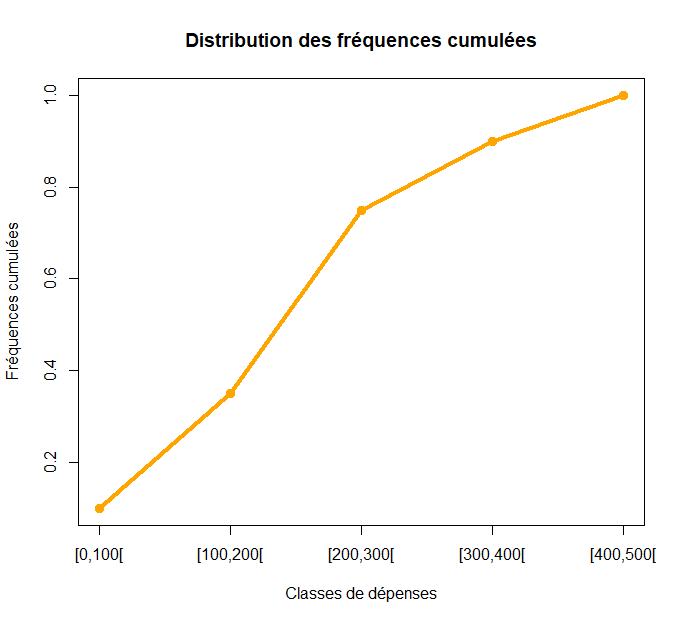
Courbe des fréquences cumulées (ogive) représentant la distribution des dépenses par classes
2) Fréquences relatives :
On divise chaque effectif par le total (100).

IntervalleEffectifFréquence relative
[0,100[100.10
[100,200[250.25
[200,300[400.40
[300,400[150.15
[400,500[100.10

Diagramme en barres montrant la distribution des fréquences relatives par classes de dépenses3)Moyenne :

Pour calculer la moyenne il faut prendre le milieu :

Le milieu de la classe est donné par :

\[
\text{centre} = \frac{\text{borne inférieure} + \text{borne supérieure}}{2}
\]

\[
\bar{x} : \text{moyenne} \quad ; \quad
n_i : \text{effectif de la classe } i \quad ; \quad
x_i : \text{centre de la classe } i \quad ; \quad
N : \text{effectif total}
\]

\[
\bar{x} = \frac{\sum n_i x_i}{N} \]

\[
\bar{x} = \frac{10 \times 50 + 25 \times 150 + 40 \times 250 + 15 \times 350 + 10 \times 450}{100} \approx 245 \text{ €}
\]

4) Classe modale :
Classe 200–300 € (effectif maximal)

5) Répartition :
Les dépenses sont concentrées autour de 200–300 €. Distribution relativement centrée.

6) Type de clientèle :
L’entreprise cible principalement des consommateurs moyens.

7) quelques propositions de stratégie marketing :
– Fidéliser les clients moyens
– Encourager la montée en gamme
– Développer une offre premium

8)25 % des clients les plus dépensiers, correspond à chercher Q3 puisque 25 % lui sont supérieur et 75% lui sont inférieur.

Les 25 % des clients les plus dépensiers dépensent plus de 300 €.

Donc, cible premium = ≥ 300 €

Exercice 3

Une entreprise analyse la satisfaction des clients après l’achat de deux produits (Produit A et Produit B) en recueillant des notes de satisfaction qui sont dans ce fichier.

Pour chaque échantillon, calculez la moyenne, la médiane, le mode et les quartiles. Précision 0.1

Réponse 1

Pour le calcul, utilisez Excel ou R ou tout autre logiciel.

Puisqu’il s’agit d’échantillons, la moyenne est\[
\bar{x}_A = 7.7, \qquad \bar{x}_B = 6.7
\]

Le produit A a une moyenne plus élevée que le produit B.

Ce graphique compare les distributions des notes de satisfaction attribuées à deux produits (A et B) à partir d’un échantillon de clients. Les courbes de densité permettent de visualiser la répartition des notes, tandis que les lignes verticales indiquent les moyennes (7.7 pour le produit A et 6.7 pour le produit B). 

Il permet ainsi de comparer deux distributions statistiques et d’interpréter une différence de moyennes entre deux groupes.
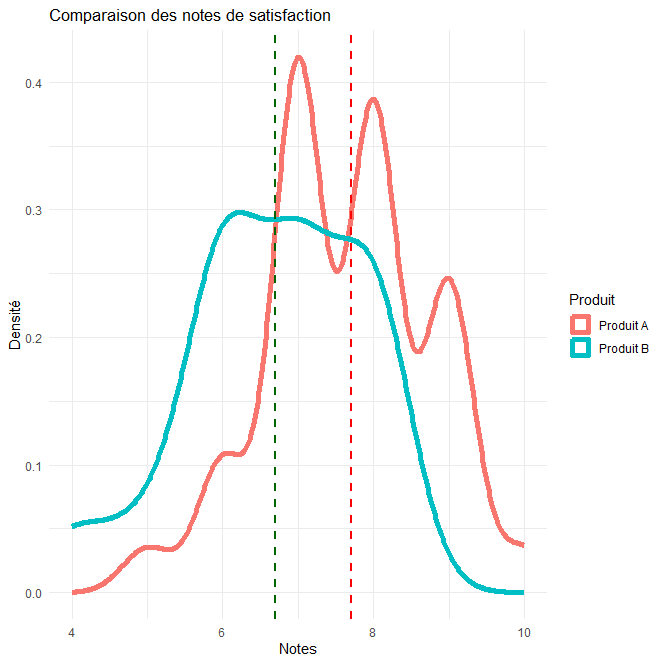
graphique de densité comparant les notes de satisfaction des produits A et B avec leurs moyennes.

Médiane A=8, Médiane B=7

Les médianes sont légèrement supérieures aux moyennes pour les deux produits
(médiane A = 8 > \( \bar{x}_A = 7.7 \) et médiane B = 7 > \( \bar{x}_B = 6.7 \)), ce qui suggère une légère asymétrie négative, c.-à-d. que la queue des valeurs est plus étendue vers les petites valeurs.

Mode A=7;  Mode B=6

Le mode (valeur la plus fréquente) du produit A est 7 , et celui du produit B est 6.

Les quartiles pour le produit A

q1=7, q2=8; q3=8

Les quartiles pour le produit B

q1=6 ; q2=7; q3=8

L’étalement des données est plus faible pour le produit A .

Les paramètres avec Rcmdr. J’ai décoché Ecart-type et Ecart interquartile et voici la sortie:

mean              0% 25% 50% 75% 100%  n
notes_A 7.657143  5   7   8   8   10 35
notes_B 6.685714  4   6   7   8    8 35

Ce boxplot compare les distributions des notes de satisfaction attribuées à deux produits (A et B). Il met en évidence les quartiles (Q1, Q2=médiane, Q3). Ce graphique permet de comprendre comment interpréter un boxplot et comparer deux distributions statistiques.
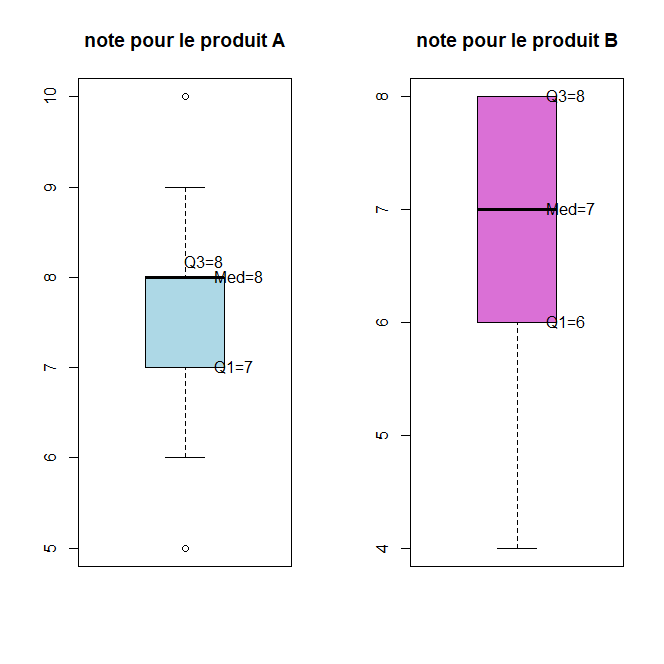
boxplot comparant les quartiles et la mediane des notes de satisfaction pour deux produits A et B

Comme vs le savez, R et Rcmdr n’ont pas une fonction directe pour le mode, alors on utilise une astuce: Dans le sous-menu Statistiques cocher la case pour afficher les fréquences et bien sûr on choisit celui qui compte  la plus grande valeur  de fréquence puisque le mode correspond à la valeur la plus fréquente et voici le résultat:

Distribution of notes_A 
      Count Percent
5         1    2.86
6         3    8.57
7        12   34.29
8        11   31.43
9         7   20.00
10        1    2.86
Total    35  100.01

Distribution of notes_B Count Percent 4 2 5.71 5 2 5.71 6 11 31.43 7 10 28.57 8 10 28.57 Total 35 99.99

En conclusion, le produit A présente des valeurs centrales plus élevées que le produit B. La dispersion, mise en évidence par les quartiles, semble légèrement différente entre les deux produits et sera vérifiée à l’aide des paramètres de dispersion.

Exercice 4

Supposons que votre ami qui est commercial vous annonce que la moyenne des ventes dans son entreprise est de 75 articles par mois, pensez-vous que c’est un des meilleurs commerciaux puisqu’il a réussi à vendre 83 articles ?

Réponse 2

Juste avec la moyenne, il est difficile d’interpréter ce résultat et de se prononcer sur la performance de ce commercial. Il faut avoir l’écart-type qui indique l’écart par rapport à la moyenne.

Exercice 5

Le directeur d’une PME voudrait déterminer la moyenne des absences au cours d’une année. Les absences observées de tous ses employés pour l’année passée sont dans ce fichier.

Calculez la moyenne des absences pour chaque équipe. Quelle conclusion pouvez vous en tirer?

Réponse 3

Le directeur prend les absences de tous ses employés, donc il s’agit de toute la population et comme chaque jour d’absence est associé à une probabilité on va donc calculer l’espérance qui  correspond à la moyenne pondérée des valeurs possibles de XX par leurs probabilités respectives:

\[E(X) = \sum_{i=1}^{n} x_i \, P(X = x_i)\]

où :

  • xix_i représente une valeur possible de la variable aléatoire XX ;
  • P(X=xi)P(X = x_i) représente la probabilité que XX prenne la valeur xix_i.

Maintenant on l’applique à notre cas:

Posons :

AJ : nombre d’absences pour l’équipe du jour

\(P(X = AJ_i)\): probabilité d’avoir ce nombre d’absences pour l’équipe du jour

AN : nombre d’absences pour l’équipe de nuit

\(P(X = AN_i)\): probabilité d’avoir ce nombre d’absences pour l’équipe de nuit.

\[E(EJ) = \sum_{i=1}^{n} AJ_i \, P(X = AJ_i)
= 0 \times 0.15 + 1 \times 0.175 + 2 \times 0.1+ 3 \times 0.1 + 4 \times 0.075 + 5 \times 0.025= 1.1\]

Notez que c’est plus simple d’utiliser R ou autre logiciel, en particulier, quand il y a beaucoup de données. Vérifiez ce résultat  avec le script R  fourni  en haut.

Espérance des absences – Équipe de jour : 1.1

Ce qui signifie qu’en moyenne l’équipe de jour compte 1.1 jour d’absences.

\[E(EN) = \sum_{i=1}^{n} AN_i \, P(X = AN_i)\]

Espérance des absences – Équipe de nuit: 0.725.

Ce qui signifie qu’en moyenne l’équipe de nuit compte 0.725 jour d’absences.

En conclusion, l’espérance des absences pour l’équipe de jour est 1.1 jours, tandis que pour l’équipe de nuit, elle est 0.725 jours. Cela signifie que, en moyenne, un employé de l’équipe de jour est absent plus souvent que celui de l’équipe de nuit.  L’entreprise pourrait examiner les raisons des absences plus fréquentes dans l’équipe de jour et envisager des ajustements comme une meilleure répartition des tâches, flexibilité des horaires, amélioration des conditions de travail. 

Exercice 6

Le médecin d’un EMS mesure le taux de glycémie à jeun en mg/dl de ses résidents. Les données sont dans ce fichier.

Calculez le taux de glycémie à jeun moyen Précision 0.01. Que pouvez-vous conclure sachant que pour les seniors, un taux normal de glycémie à jeun devrait se situer entre 140 et 150 mg/dl ?

Réponse 4

Puisqu’il s’agit de tous les résidents et que chaque taux de glycémie (TG) est associé à un effectif ni, la moyenne calculée est une moyenne pondérée de la population:

\[
\mu = \frac{\sum n_i \, TG_i}{\sum n_i} = 161.12
\]

Or, pour les seniors, un taux normal de glycémie à jeun devrait se situer entre 140 et 150 mg/dl. Cette moyenne suggère donc que certains résidents pourraient être diabétiques, car leur glycémie dépasse le seuil recommandé.

🎁 Votre checklist mémoire offerte

Retenez durablement ce que vous apprenez, grâce aux réflexes issus de la science de la mémoire.

Puis une méthode tous les jeudis. Désinscription en un clic. Consultez notre politique de confidentialité pour plus d’informations.